[AI] Claude Code 서브 에이전트 팀 작업 흐름과 안전 규칙 (2/2)
· IT기술 › AI
1편에서는 조직표와 정의 파일을 만들었다. 그런데 순서가 문서에 없으면 PM 이 "이번엔 누구부터 부르지?"를 매번 새로 판단한다. 그래서 이번에는 기능 하나를 개발할 때 누가 어떤 순서로 참여할지 정의해 보았다.
1. 기능 개발 진행 순서
프로젝트를 처음 만들 때는 0단계(초기 세팅)를 한 번 거친다. 스택을 정하고 골격·테스트 기반·E2E 환경을 만든다. 그 뒤 기능마다 아래 순서로 간다.
- 리서치 : planning-researcher (큰 기능만)
- 기획 : planning-spec 이 PRD(요구사항 정의서) 와 인수 조건 작성 → 사람 승인
- 설계 : be-api 가 API 명세, dba 가 스키마 → 사람 승인
- 구현 : be-domain → be-api, 프론트는 fe-feature 가 mock 으로 병렬
- 팀 리뷰 : be-reviewer, fe-reviewer, 필요하면 dba·보안 (병렬)
- QA : 인수 조건별 PASS / FAIL
- 배포 : 보안 점검 → infra 준비 → 사람 승인
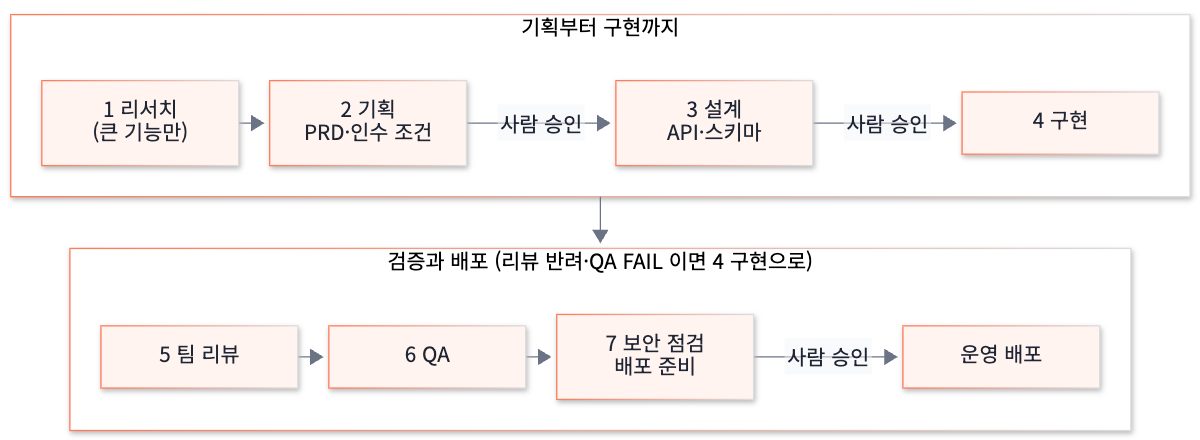
모든 기능이 일곱 단계를 다 거치지는 않는다. 버그 하나나 문구 수정은 구현 담당과 리뷰어만 거치고, 배포 전 보안 점검만 함께 받는다. 대신 DB 스키마(제약·인덱스 포함), API 계약, 결제·개인정보 처리, 비용 중 하나라도 바뀌면 작은 수정으로 보지 않는다. 최소 중간 규모로 올려 설계 단계와 승인을 다시 거친다.
2. 인수인계는 리포트 파일로
짧은 보고와 상세 파일로 나누는 기본 방식은 Claude Code 서브 에이전트로 AI에게 일 맡기는 법에서 다뤘다. 여기서는 바뀐 점만 적는다.
docs/handoff/order-cancel/
├── README.md          # 진행판 (PM 관리)
├── 02-planning-spec.md
├── 03-be-api.md
└── 04-dba.md
PM 은 리포트를 요약해서 다음 담당에게 옮겨 적지 않고, 경로만 넘긴다. 무엇이 필요한지는 다음 담당이 더 잘 안다. 저장한 리포트는 고치지 않는다. 다시 작업하면 새 번호로 쓰고 이전 리포트를 적는다. 진행판만 읽어도 무슨 일이 몇 번 반복됐는지 보인다.
에이전트끼리는 직접 부르지 않는다. 공식 문서 기준으로 서브 에이전트는 기본적으로 다른 서브 에이전트를 부를 수 있다(메인 대화 아래 세 단계까지). 내 정의 파일은 tools 를 직접 적고 Agent 를 넣지 않아서 담당끼리는 부를 수 없다. 일부러 그렇게 뒀다. 담당끼리 직접 부르면 기록이 남지 않고, 누가 무엇을 결정했는지 PM 도 모르게 된다. 프로젝트 전체에서 끄려면 환경 변수 CLAUDE_CODE_MAX_SUBAGENT_SPAWN_DEPTH 를 1 로 두면 된다.
3. 리뷰가 계속 반려될 때
리뷰 지적은 Blocker, Major, Minor 세 단계로 나누고, 항목마다 고칠 담당을 붙인다. Blocker 와 Major 가 0건이어야 승인이다. 반려되면 지적된 담당이 고치고 같은 리뷰어가 다시 본다.
같은 기능에서 같은 리뷰어가 세 번째로 반려하면 사람에게 보고한다. 이 고리는 누가 끊어 주지 않으면 계속 돈다.
4. 병렬로 맡길 때 생긴 충돌
블로그 백엔드에서 두 담당에게 같은 저장소 작업을 동시에 맡긴 적이 있다. 맡긴 일은 서로 달랐는데 테스트가 EOFException 으로 자꾸 깨졌다. 같은 작업 트리의 Gradle 빌드 폴더를 함께 쓰고 있었다. 작업 트리를 임시 폴더로 복사해서 테스트를 돌리자 통과했다.
그 뒤로 규칙을 정했다. 같은 폴더에서 의존성 설치나 빌드를 하는 작업은 동시에 맡기지 않는다. 꼭 병렬로 돌려야 하면 테스트는 작업 트리를 임시 폴더로 복사하거나 git worktree 로 만든 별도 작업 트리에서 실행한다.
정의 파일에 isolation: worktree 를 쓰면 서브 에이전트를 임시 worktree 에서 돌릴 수도 있다. 이 worktree 는 지금 브랜치가 아니라 기본 브랜치에서 갈라진다. 기능 브랜치에서 작업 중이라면 그 브랜치의 커밋도, 커밋하지 않은 변경도 들어가지 않는다.
5. 어디서 멈추게 했나
운영 DB 규칙과 덤프 적재 규칙은 실제로 일이 생긴 뒤에 붙었고, 나머지는 그런 일이 나기 전에 미리 막아 둔 것이다.
- 운영 DB 는 사람이 실행한다 : 처음에는 인프라 담당이 운영 DB 반영까지 실행하려 했는데, Claude Code 자동 모드(Auto Mode)의 분류기가 그 명령을 거부했다. 담당은 우회하지 않고 보고했고 그 단계는 내가 직접 실행했다. 그 뒤로 에이전트는 SQL 과 되돌리기 스크립트까지만 쓴다.
- 덤프는 받을 DB 를 확인하고 넣는다 : 검수 담당이 비교용으로 덤프를 임시 DB 에 넣으려 했는데, 덤프 안에 원래 DB 를 고르는
USE문이 들어 있었다. 결과적으로 임시 DB 가 아니라 로컬 작업 DB 가 덮어써졌다. DB 담당이 복구했고, 덤프를 넣을 때의 경고와 절차를 문서에 추가했다. - DB 를 지우는 명령과 오래 도는 서버는 PM 만 : 에이전트가 각자 서버를 띄우면 누가 띄웠는지 모르는 프로세스가 남는다.
- 비용이 드는 명령은 확인 창을 띄운다 : 권한 설정의
ask규칙으로 클라우드 리소스 생성 같은 명령에 확인 창이 뜨게 했다. 규칙은 deny → ask → allow 순서로 판단된다.
마지막 규칙에는 한 줄을 덧붙였다. 권한 규칙은 모든 명령 형태를 잡지 못하니, 규칙에 안 걸려도 운영 문서의 금지 사항이 우선이고, 확인 창을 피하려고 명령 형태를 바꾸지 않는다.
운영 문서를 다시 읽어 보니 규칙 대부분이 "어디서 멈추고 사람에게 넘기는가"에 관한 것이었다. 처음 팀을 꾸린다면 역할 12개를 다 만들기보다 구현 담당 하나와 리뷰어 하나, 그리고 사람이 승인할 지점 세 곳부터 정해 보길 권한다.